Tích hợp dữ liệu chuyển đổi số được thực hiện thế nào?
Mục lục
- Tích hợp dữ liệu là một chuỗi từ nguồn đến hành động nghiệp vụ
- Nguồn dữ liệu phải được lập bản đồ trước khi kết nối hệ thống
- Cách đồng bộ dữ liệu phụ thuộc độ trễ, khối lượng và tính nhất quán
- Chuẩn hóa ngữ nghĩa giúp các hệ thống hiểu cùng một dữ liệu
- Lớp tích hợp tách hệ thống nguồn khỏi hệ thống sử dụng dữ liệu
- Dữ liệu chỉ tạo ra chuyển đổi số khi được gắn vào quy trình vận hành
- Quản trị, bảo mật và giám sát phải đi cùng luồng tích hợp
Tích hợp dữ liệu chuyển đổi số được triển khai bằng cách kết nối nguồn dữ liệu với lớp tích hợp, chuẩn hóa ngữ nghĩa, đồng bộ sang hệ thống cần sử dụng và đưa dữ liệu vào đúng bước của quy trình vận hành.
Tích hợp dữ liệu trong chuyển đổi số không đơn thuần là chuyển dữ liệu từ hệ thống cũ sang một kho mới. Về bản chất, doanh nghiệp phải thiết kế một luồng có kiểm soát: xác định dữ liệu phát sinh ở đâu, hệ thống nào chịu trách nhiệm về dữ liệu đó, dữ liệu được thu nhận và chuẩn hóa bằng cách nào, hệ thống nào được phép sử dụng, khi nào dữ liệu phải đồng bộ và dữ liệu sẽ kích hoạt bước nghiệp vụ nào tiếp theo.
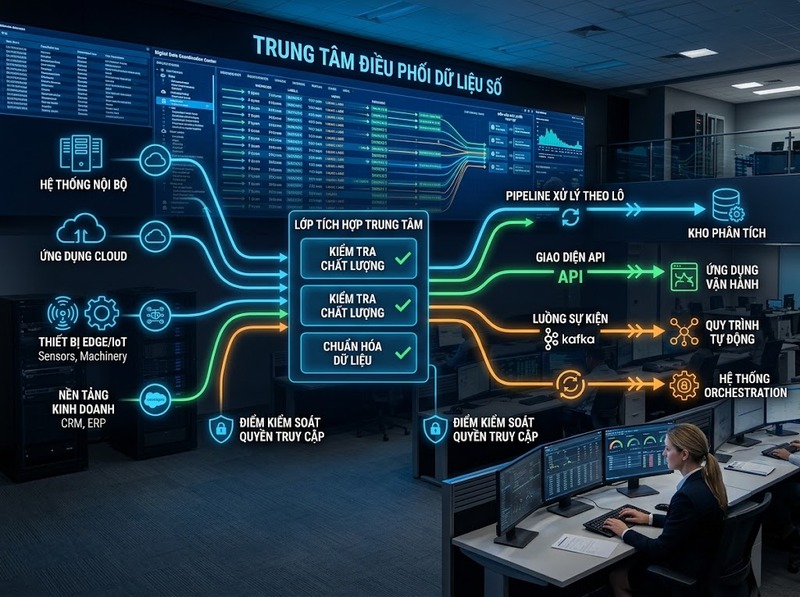
Vì vậy, một kiến trúc tích hợp thường kết hợp nhiều cơ chế. Dữ liệu phân tích có thể đi qua ETL/ELT vào kho dữ liệu; giao dịch giữa ứng dụng có thể sử dụng API; các thay đổi cần phản ứng nhanh có thể truyền bằng message hoặc event; toàn bộ luồng được orchestration để gắn với logic nghiệp vụ. Kiến trúc tích hợp hiện đại cũng không giới hạn ở cloud mà có thể nối ứng dụng, dữ liệu, dịch vụ và thiết bị giữa môi trường on-premises, cloud và edge.
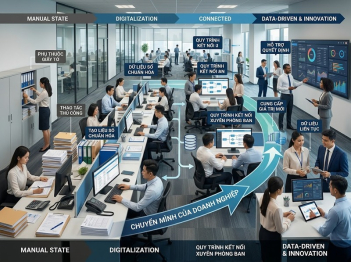
Tích hợp dữ liệu là một chuỗi từ nguồn đến hành động nghiệp vụ
Một luồng tích hợp hoàn chỉnh thường bắt đầu tại hệ thống phát sinh dữ liệu, đi qua lớp thu nhận và xử lý, sau đó được cung cấp cho ứng dụng hoặc nền tảng cần sử dụng. Điểm cuối không nhất thiết là một cơ sở dữ liệu. Trong chuyển đổi số, điểm cuối có thể là một quyết định, một tác vụ, một cảnh báo hoặc một bước tự động trong quy trình.
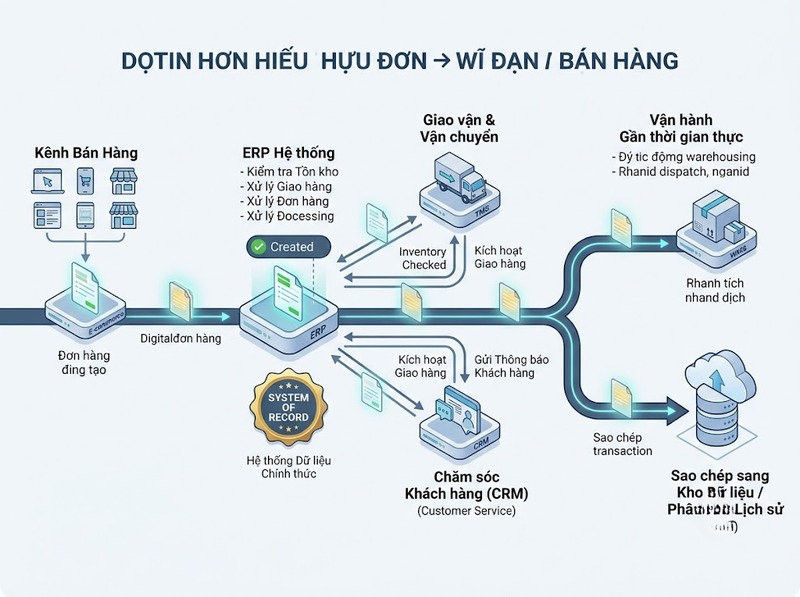
Chẳng hạn, thông tin đơn hàng có thể bắt đầu từ kênh bán hàng, được xác thực và chuyển tới hệ thống ERP để kiểm tra tồn kho. Khi trạng thái đơn thay đổi, sự kiện mới lại được chuyển tới hệ thống chăm sóc khách hàng hoặc quy trình giao vận. Dữ liệu vì thế vừa đi qua nhiều hệ thống vừa mang trạng thái của quy trình nghiệp vụ.
Chuỗi này chỉ hoạt động ổn định khi doanh nghiệp xác định được system of record cho từng nhóm dữ liệu. Hệ thống nhận bản sao không tự động trở thành nguồn dữ liệu chính thức. Nếu hai hệ thống cùng được phép sửa một thuộc tính nhưng không có quy tắc phân quyền và đồng bộ rõ ràng, xung đột dữ liệu sẽ xuất hiện ngay cả khi kết nối kỹ thuật vẫn hoạt động.
Không phải mọi dữ liệu đều cần tập trung về một nơi. Dữ liệu phục vụ phân tích thường phù hợp với kho dữ liệu hoặc lakehouse, trong khi dữ liệu giao dịch có thể tiếp tục nằm trong hệ thống nguồn và được cung cấp qua API hoặc event. Việc phân biệt hai nhu cầu này giúp tránh thiết kế một nền tảng duy nhất phải đồng thời xử lý cả giao dịch thời gian thực lẫn phân tích lịch sử.
Nguồn dữ liệu phải được lập bản đồ trước khi kết nối hệ thống
Trước khi xây dựng connector hoặc pipeline, cần biết chính xác dữ liệu nào đang tồn tại và ý nghĩa nghiệp vụ của nó. Một trường customer_id trong CRM và một trường có tên tương tự trong ERP chưa chắc đại diện cho cùng một định danh. Nếu kết nối được triển khai trước khi làm rõ quan hệ này, hệ thống có thể truyền dữ liệu đúng định dạng nhưng sai đối tượng.
Bản đồ nguồn–đích nên xác định ít nhất đối tượng dữ liệu, trường dữ liệu, kiểu dữ liệu, đơn vị đo, khóa định danh, ý nghĩa nghiệp vụ, chủ sở hữu, hệ thống nguồn, hệ thống tiêu thụ, tần suất cập nhật và mức độ nhạy cảm. Metadata và định nghĩa dùng chung đặc biệt quan trọng khi nhiều phòng ban hoặc nhiều nền tảng cùng trao đổi dữ liệu. ISO/IEC 11179-1:2023 cung cấp khung khái niệm cho metadata và metadata registry, phản ánh vai trò của việc mô tả dữ liệu nhất quán trước khi dữ liệu được chia sẻ rộng hơn.
Ở bước này cũng cần xác định dữ liệu nào là master data, reference data và transaction data. Khách hàng, sản phẩm hay nhà cung cấp có thể cần một quy tắc quản lý định danh chung; trạng thái đơn hàng lại là dữ liệu giao dịch thay đổi liên tục. Dùng cùng một phương pháp đồng bộ cho tất cả các loại dữ liệu thường dẫn đến thiết kế quá phức tạp hoặc không đáp ứng được độ trễ cần thiết.
Một kết quả quan trọng của bước lập bản đồ là data contract giữa hệ thống gửi và hệ thống nhận. Contract quy định schema, trường bắt buộc, mã giá trị, phiên bản và cách xử lý thay đổi. Khi schema được thay đổi có kiểm soát, hệ thống nhận có thể nâng cấp theo phiên bản thay vì hỏng đột ngột sau một thay đổi ở hệ thống nguồn.
Cách đồng bộ dữ liệu phụ thuộc độ trễ, khối lượng và tính nhất quán
Không có một kỹ thuật tích hợp phù hợp cho mọi luồng dữ liệu. Batch, API, CDC và event giải quyết những yêu cầu khác nhau. Việc lựa chọn nên bắt đầu từ yêu cầu của quy trình: dữ liệu phải mới đến mức nào, một lần truyền bao nhiêu dữ liệu, hệ thống nào được quyền ghi, có cần phản hồi ngay hay không và có chấp nhận trạng thái chưa đồng nhất trong một khoảng thời gian hay không.
ETL và ELT phù hợp với dữ liệu cần gom và xử lý theo lô
ETL thực hiện ba bước extract, transform và load: lấy dữ liệu từ nhiều nguồn, áp dụng quy tắc biến đổi rồi đưa dữ liệu vào nơi đích. ELT thay đổi thứ tự bằng cách đưa dữ liệu vào hệ thống đích trước rồi sử dụng năng lực tính toán của chính hệ thống đó để biến đổi. Hai mô hình đặc biệt phù hợp khi cần hợp nhất lượng dữ liệu đáng kể cho phân tích, báo cáo hoặc xử lý lịch sử.
Trong pipeline thực tế, transformation thường bao gồm chuẩn hóa kiểu dữ liệu, lọc bản ghi, nối dữ liệu, xử lý trùng lặp, kiểm tra hợp lệ và áp dụng quy tắc nghiệp vụ. Vì dữ liệu được xử lý theo lô, batch không phù hợp nếu một bước nghiệp vụ yêu cầu phản ứng ngay sau khi dữ liệu thay đổi.
API phù hợp khi hệ thống cần trao đổi theo yêu cầu
API thường được dùng khi một ứng dụng cần đọc hoặc ghi dữ liệu tại thời điểm phát sinh yêu cầu. Ví dụ, ứng dụng bán hàng có thể hỏi hệ thống tồn kho về số lượng khả dụng trước khi xác nhận đơn. Hệ thống nguồn vẫn giữ quyền sở hữu dữ liệu, còn ứng dụng gọi API nhận kết quả cần thiết mà không phải sao chép toàn bộ tập dữ liệu.
Đổi lại, tích hợp đồng bộ tạo phụ thuộc trực tiếp vào khả năng phản hồi của hệ thống phía sau. Một chuỗi nhiều API gọi nối tiếp nhau có thể khiến lỗi hoặc độ trễ của một dịch vụ lan sang cả quy trình. Với luồng không cần phản hồi tức thời, message hoặc event thường giúp tách các hệ thống khỏi nhau tốt hơn.
CDC và event phù hợp với thay đổi cần được truyền nhanh
Change Data Capture tập trung vào việc nhận biết dữ liệu đã thay đổi thay vì đọc lại toàn bộ bảng. Event-driven integration đi thêm một bước: hệ thống phát sinh sự kiện, event channel hoặc broker tiếp nhận sự kiện và một hay nhiều consumer xử lý sự kiện đó. Kiến trúc này cho phép producer và consumer tách rời, đồng thời hỗ trợ các luồng cần phản ứng gần thời gian thực.
Tách rời cũng tạo ra một giới hạn quan trọng: dữ liệu giữa các hệ thống có thể đạt eventual consistency thay vì đồng nhất ngay lập tức. Do đó, thiết kế event cần tính tới thứ tự sự kiện, xử lý trùng, retry, khả năng phát lại và tính idempotent để một thông điệp được xử lý lại không gây ra giao dịch sai.
“Thời gian thực” không nên là yêu cầu định tính. Quy trình phải đặt mục tiêu đo được, chẳng hạn một cảnh báo nội bộ yêu cầu dữ liệu đến trong vòng 60 giây, trong khi báo cáo ngày chỉ cần hoàn tất theo chu kỳ T 1. Sau khi có SLO về freshness hoặc latency, doanh nghiệp mới có cơ sở chọn batch, API, CDC hay event.
Chuẩn hóa ngữ nghĩa giúp các hệ thống hiểu cùng một dữ liệu
Kết nối thành công về mặt kỹ thuật chưa có nghĩa là dữ liệu đã được tích hợp đúng. Hai hệ thống có thể truyền cùng một giá trị nhưng hiểu giá trị đó khác nhau. Một mã trạng thái 01, một đơn vị tiền tệ thiếu mã quốc gia hoặc một thời điểm không có timezone đều có thể tạo ra sai lệch khi dữ liệu đi qua nhiều hệ thống.
Lớp chuẩn hóa cần xử lý schema, datatype, timezone, đơn vị đo, mã tham chiếu, định danh và quy tắc chuyển đổi. ISO 8000-110:2021 đề cập đến cú pháp, semantic encoding và sự phù hợp với data specification trong trao đổi master data. ISO/TS 8000-82:2022 mô tả việc xây dựng data rules và sử dụng data profiling để duy trì tính toàn vẹn, độ tin cậy của dữ liệu. Hai tài liệu này không tạo ra một mô hình dữ liệu chung cho mọi doanh nghiệp, nhưng cho thấy chất lượng tích hợp phụ thuộc cả cấu trúc lẫn ý nghĩa dữ liệu.
Master data cần thêm cơ chế đối chiếu định danh và xử lý bản ghi trùng. Nếu CRM lưu “Công ty A” còn ERP lưu cùng doanh nghiệp dưới một mã khác, hệ thống tích hợp phải có quy tắc xác định hai bản ghi có đại diện cho cùng một thực thể hay không. Chỉ sau khi có quy tắc ownership và survivorship rõ ràng mới nên hình thành một bản ghi hợp nhất để các hệ thống khác sử dụng.
Cần tránh một hiểu nhầm phổ biến: chuẩn hóa không có nghĩa là buộc mọi hệ thống dùng một schema vật lý giống nhau. Mỗi ứng dụng có thể duy trì mô hình tối ưu cho nghiệp vụ riêng, trong khi lớp tích hợp sử dụng mapping, contract hoặc canonical representation để chuyển đổi giữa các mô hình đó.
Lớp tích hợp tách hệ thống nguồn khỏi hệ thống sử dụng dữ liệu
Khi số lượng ứng dụng tăng, tích hợp point-to-point trực tiếp giữa từng cặp hệ thống trở nên khó quản lý vì mỗi thay đổi có thể ảnh hưởng nhiều kết nối. Lớp tích hợp tạo một ranh giới trung gian để quản lý API, message, event và pipeline theo các hợp đồng rõ ràng hơn.
Tùy kiến trúc, lớp này có thể bao gồm API gateway hoặc API management, message broker, nền tảng orchestration, pipeline ETL/ELT, schema registry, catalog và cơ chế quan sát. Microsoft Azure Architecture Center cũng phân biệt việc gọi API trực tiếp với giao tiếp bất đồng bộ qua messaging hoặc event, đồng thời coi orchestration là thành phần cần thiết để định nghĩa và thực thi logic workflow.
Orchestration phải kiểm soát cả đường đi bình thường lẫn đường đi khi lỗi. Một message không gửi được cần có retry có giới hạn; lỗi không thể tự phục hồi cần được đưa vào dead-letter queue hoặc cơ chế tương đương; mỗi giao dịch nên có correlation ID để truy vết qua nhiều hệ thống. Khi consumer có thể nhận cùng một sự kiện nhiều lần, thao tác ghi cần được thiết kế idempotent để tránh tạo đơn hàng, thanh toán hoặc bản ghi lặp.
Không nhất thiết phải dồn tất cả cơ chế vào một sản phẩm duy nhất. Một doanh nghiệp có thể dùng API cho giao dịch đồng bộ, broker cho sự kiện nghiệp vụ và ELT cho dữ liệu phân tích. Điều quan trọng là các cơ chế cùng tuân thủ ownership, data contract, security policy và mô hình giám sát thống nhất.
Dữ liệu chỉ tạo ra chuyển đổi số khi được gắn vào quy trình vận hành
Một pipeline đưa dữ liệu vào kho thành công mới giải quyết phần vận chuyển. Chuyển đổi số đòi hỏi dữ liệu đó được sử dụng tại đúng điểm của quy trình để thay đổi cách hệ thống hoặc con người ra quyết định và thực hiện công việc.
Luồng vận hành thường có dạng vòng kín. Một hệ thống phát sinh dữ liệu hoặc event; rule, ứng dụng hoặc mô hình phân tích sử dụng dữ liệu để xác định hành động; workflow tạo bước xử lý tiếp theo; kết quả của bước đó lại được ghi về hệ thống liên quan và trở thành dữ liệu đầu vào cho chu kỳ sau.
Ví dụ, khi tồn kho thay đổi, event có thể cập nhật lượng hàng khả dụng trên kênh bán và đồng thời kích hoạt quy trình bổ sung hàng nếu đạt điều kiện nội bộ. Với dữ liệu khách hàng, một thay đổi đã được xác thực có thể được cung cấp cho quy trình chăm sóc để nhân viên nhìn thấy thông tin mới nhất thay vì nhập lại dữ liệu từ hệ thống khác.
Thiết kế ở cấp quy trình phải xác định rõ dữ liệu nào là điều kiện đầu vào, độ mới tối đa được chấp nhận, hành động nào được phép tự động, trường hợp nào cần con người xác nhận và trạng thái nào phải ghi trả lại. Nếu thiếu phần write-back này, hệ thống có thể đọc được dữ liệu mới nhưng quy trình vẫn bị đứt đoạn vì kết quả xử lý không quay trở lại chuỗi thông tin.
Hiệu quả tích hợp vì thế nên được đo ở cả cấp kỹ thuật và cấp quy trình. Ngoài việc pipeline có chạy hay không, cần theo dõi data freshness, tỷ lệ giao dịch tích hợp thành công, sai lệch khi reconciliation, số trường hợp phải nhập lại thủ công và số tác vụ bị chặn do dữ liệu thiếu hoặc không hợp lệ. Mục tiêu cụ thể phải xuất phát từ SLA hoặc SLO của quy trình nghiệp vụ thay vì dùng một ngưỡng chung cho mọi hệ thống.
Quản trị, bảo mật và giám sát phải đi cùng luồng tích hợp
Khi dữ liệu đi qua nhiều ứng dụng, số điểm truy cập và số bản sao có thể tăng. Vì thế quyền sở hữu, phân loại dữ liệu và chính sách truy cập phải được áp dụng ngay trong kiến trúc tích hợp, không bổ sung sau khi connector đã đi vào vận hành.
Mỗi service nên sử dụng danh tính và quyền riêng phù hợp với chức năng của nó thay vì chia sẻ tài khoản chung. NIST SP 800-207 về Zero Trust nhấn mạnh rằng không nên mặc nhiên tin cậy người dùng, thiết bị hoặc hệ thống chỉ dựa trên vị trí mạng; quyền truy cập tài nguyên phải dựa trên việc xác thực và cấp quyền phù hợp. Nguyên tắc này đặc biệt quan trọng khi tích hợp kéo dài qua mạng nội bộ, SaaS và nhiều môi trường cloud.
Chất lượng dữ liệu cũng cần được đo liên tục. Các chỉ số thực tế thường xoay quanh completeness, validity, uniqueness, freshness, độ trễ pipeline, tỷ lệ message lỗi, số bản ghi chờ retry và chênh lệch khi đối soát giữa hệ thống nguồn với hệ thống đích. Không có một ngưỡng chuẩn duy nhất cho tất cả các quy trình; mục tiêu phải đủ chặt để đáp ứng yêu cầu nghiệp vụ của luồng đang sử dụng dữ liệu.
Cuối cùng, lineage và audit log phải cho phép truy ngược một dữ liệu đã đến từ đâu, đi qua transformation nào, được hệ thống nào sử dụng và lỗi xuất hiện ở bước nào. Khi kết hợp lineage với monitoring, schema versioning và quy trình reprocessing, đội vận hành có thể sửa lỗi tích hợp mà không phải đoán dữ liệu đã bị thay đổi ở đâu.
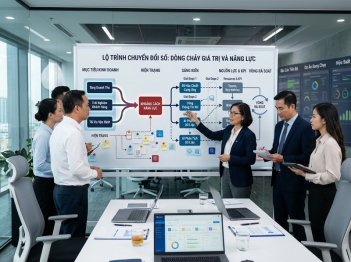
Tích hợp dữ liệu chuyển đổi số vì vậy là quá trình thiết kế một dòng chảy có quản trị từ nguồn dữ liệu → cơ chế thu nhận và đồng bộ → chuẩn hóa → lớp kết nối → hệ thống sử dụng → quy trình nghiệp vụ → phản hồi và giám sát. Thành công không được xác định chỉ bởi việc hai hệ thống “đã kết nối”, mà bởi việc dữ liệu đúng nghĩa, đúng quyền, đủ mới và có thể đi đến đúng điểm cần sử dụng.
Cách triển khai bền vững là bắt đầu từ quy trình và quyền sở hữu dữ liệu, sau đó mới chọn ETL/ELT, API, CDC hoặc event phù hợp. Khi data contract, chất lượng, bảo mật, orchestration và khả năng quan sát được thiết kế cùng nhau, dữ liệu mới có thể luân chuyển giữa nguồn, hệ thống và quy trình mà không làm mất kiểm soát về tính nhất quán hoặc trách nhiệm quản trị.

GỬI Ý KIẾN BÌNH LUẬN
Bài xem nhiều