Tích hợp dữ liệu giữa các hệ thống được thực hiện thế nào?
Mục lục
- Quy trình tích hợp dữ liệu giữa hai hệ thống diễn ra qua 6 bước
- Ánh xạ và biến đổi quyết định dữ liệu có đúng nghĩa ở hệ thống đích hay không
- Batch, API, message và CDC truyền dữ liệu theo các cơ chế khác nhau
- Đồng bộ đúng cần kiểm soát định danh, thứ tự và tính lặp an toàn
- Khi tích hợp lỗi, hệ thống phải retry, cách ly và đối soát
- Cơ chế phù hợp phụ thuộc độ trễ, khối lượng và mức nhất quán cần thiết
Tích hợp dữ liệu kết nối hệ thống nguồn và đích qua batch, API, message/event hoặc CDC; dữ liệu được ánh xạ, biến đổi, kiểm tra và ghi nhận với cơ chế kiểm soát trùng lặp, lỗi và độ nhất quán.
Tích hợp dữ liệu không chỉ là sao chép bản ghi từ hệ thống A sang hệ thống B. Một luồng tích hợp hoàn chỉnh phải giải quyết ba việc: dữ liệu được lấy hoặc phát ra bằng kênh nào, dữ liệu nguồn được chuyển sang mô hình của hệ thống đích ra sao, và điều gì xảy ra khi dữ liệu đến chậm, bị lặp, sai định dạng hoặc truyền thất bại.
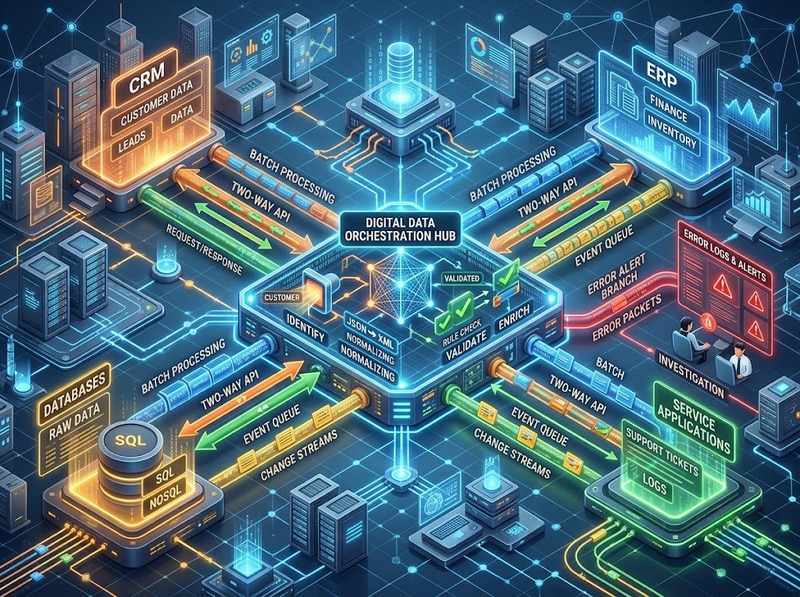
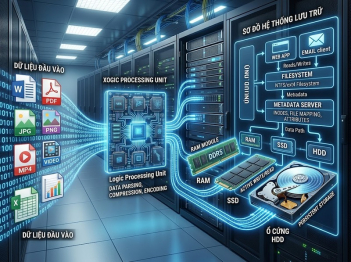
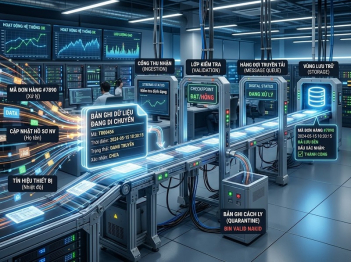
Ở mức kỹ thuật, dữ liệu thường đi qua connector, API, tác vụ batch/ETL, message broker hoặc cơ chế change data capture (CDC). Dù kênh truyền khác nhau, logic cốt lõi vẫn là đọc hoặc nhận dữ liệu → xác định bản ghi và ánh xạ trường → biến đổi, kiểm tra → truyền → ghi vào đích → xác nhận, theo dõi và đối soát.
Quy trình tích hợp dữ liệu giữa hai hệ thống diễn ra qua 6 bước
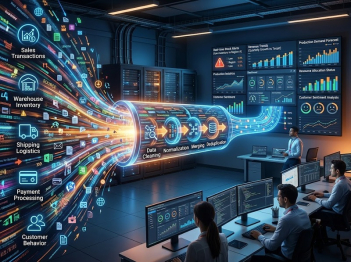
Một luồng tích hợp dữ liệu có thể được nhìn như chuỗi xử lý từ nguồn đến đích. Sáu bước này không nhất thiết nằm trong sáu chương trình riêng biệt; chúng là sáu nhiệm vụ mà kiến trúc tích hợp phải giải quyết.
1. Xác lập điểm kết nối và hợp đồng dữ liệu: Xác định hệ thống nào là nguồn, hệ thống nào là đích, dữ liệu nào được trao đổi, khi nào luồng chạy và bên nhận kỳ vọng schema gì. Với tích hợp qua API, HTTP có thể cung cấp cơ chế request/response, JSON có thể làm định dạng payload và OpenAPI có thể mô tả contract của endpoint. Đây là các lựa chọn phổ biến, không phải điều kiện bắt buộc cho mọi tích hợp
2. Đọc hoặc nhận dữ liệu nguồn: Dữ liệu có thể được truy vấn theo lịch, nhận khi có request, nhận từ hàng đợi sự kiện hoặc thu từ transaction log của cơ sở dữ liệu. Cách lấy dữ liệu quyết định độ trễ và mức phụ thuộc giữa hai hệ thống
3. Nhận diện bản ghi và ánh xạ schema: Hệ thống phải biết một khách hàng, đơn hàng hay sản phẩm ở nguồn tương ứng với thực thể nào ở đích. Việc này thường dựa vào business key, ID ánh xạ và quy tắc field-to-field
4. Biến đổi và kiểm tra: Kiểu dữ liệu, đơn vị, timezone, mã trạng thái, enum hoặc cấu trúc lồng nhau có thể phải chuyển đổi. Validation loại hoặc cách ly dữ liệu thiếu trường bắt buộc, sai kiểu hoặc vi phạm quy tắc của hệ thống đích
5. Truyền và ghi dữ liệu: Bản ghi sau xử lý được gửi qua kênh tích hợp rồi insert, update hoặc upsert vào đích. Upsert hữu ích khi cùng một bản ghi có thể được gửi lại vì nó cho phép cập nhật nếu đã tồn tại thay vì tạo thêm bản sao
6. Xác nhận, theo dõi và đối soát: Hệ thống ghi nhận trạng thái thành công/thất bại, lưu thông tin truy vết và kiểm tra lại số bản ghi hoặc trạng thái nguồn–đích. Bước này giúp phát hiện trường hợp “đã gửi” nhưng chưa thực sự được hệ thống đích chấp nhận
Ví dụ, khi CRM gửi đơn hàng sang ERP, trường customer_id ở CRM có thể phải đổi sang customer_code của ERP; thời gian tạo đơn phải chuẩn hóa timezone; mã trạng thái phải ánh xạ sang tập giá trị ERP chấp nhận. Chỉ khi các bước đó hoàn tất, việc “gửi thành công” mới đồng nghĩa với dữ liệu có thể dùng đúng ở hệ thống đích.
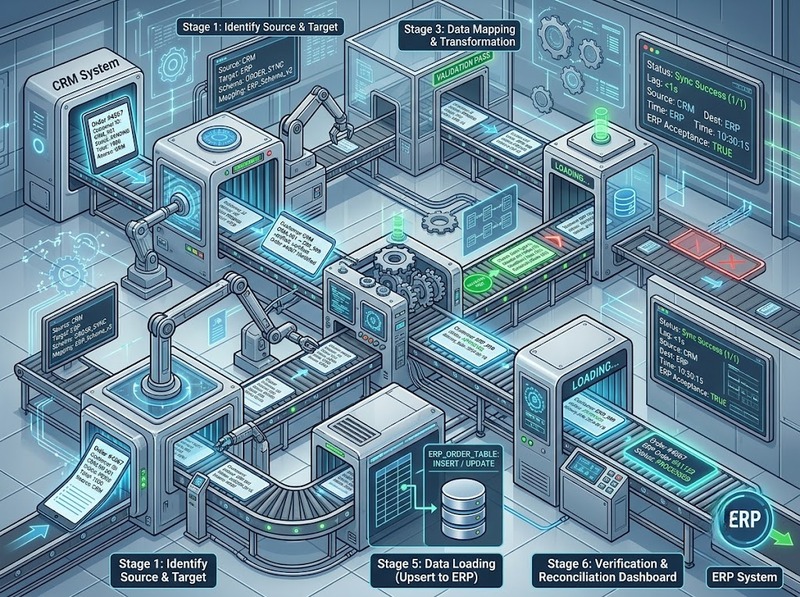
Ánh xạ và biến đổi quyết định dữ liệu có đúng nghĩa ở hệ thống đích hay không
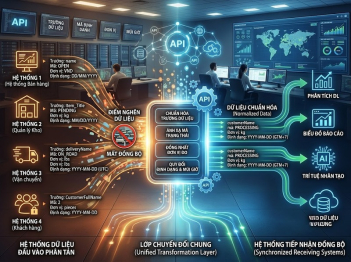
Hai hệ thống hiếm khi mô tả cùng một thực thể theo đúng một cấu trúc. Một hệ thống có thể dùng status = 1, hệ thống khác dùng ACTIVE; nguồn lưu thời gian theo UTC nhưng đích hiển thị theo múi giờ nghiệp vụ; một bên dùng ID nội bộ, bên kia dùng mã khách hàng. Vì vậy, tích hợp phải giải quyết cả cú pháp lẫn ngữ nghĩa.
Schema mapping trả lời câu hỏi “trường nào đi vào trường nào”. Identity mapping trả lời “bản ghi này ở nguồn là bản ghi nào ở đích”. Transformation xử lý chênh lệch về kiểu dữ liệu, định dạng, đơn vị và tập giá trị. Validation kiểm tra dữ liệu sau biến đổi có đáp ứng điều kiện mà hệ thống đích yêu cầu hay không.
Điểm dễ nhầm là payload hợp lệ chưa chắc dữ liệu đã đúng. Một chuỗi JSON có thể hoàn toàn đúng cú pháp nhưng vẫn gán sai đơn vị tiền tệ, sai mã khách hàng hoặc sai ý nghĩa của trường trạng thái. Vì thế data contract chỉ phát huy tác dụng khi mô tả rõ cả cấu trúc và quy ước sử dụng dữ liệu; với dữ liệu quan trọng, quy tắc ánh xạ cần được quản lý cùng phiên bản schema để thay đổi ở nguồn không âm thầm làm sai dữ liệu ở đích.
Không phải luồng nào cũng cần biến đổi phức tạp. Nếu hai hệ thống đã chia sẻ cùng mô hình và cùng mã định danh, lớp transformation có thể rất mỏng. Nhưng việc xác minh điều đó vẫn cần thiết, bởi bỏ qua mapping chỉ an toàn khi ý nghĩa dữ liệu thực sự tương thích.
Batch, API, message và CDC truyền dữ liệu theo các cơ chế khác nhau
Batch/ETL gom dữ liệu theo đợt
Batch đọc một tập dữ liệu theo lịch hoặc theo cửa sổ thời gian, sau đó biến đổi và nạp sang đích. Cách này phù hợp khi dữ liệu không cần xuất hiện ngay, khối lượng mỗi lần xử lý lớn hoặc hệ thống nguồn không muốn chịu nhiều request nhỏ liên tục. Độ mới của dữ liệu bị giới hạn bởi lịch chạy: nếu job chạy mỗi giờ, dữ liệu có thể chậm gần một chu kỳ ngay cả khi job xử lý rất nhanh.
Điểm cần kiểm soát là khả năng chạy lại. Một batch thất bại ở giữa phải biết phần nào đã ghi thành công, phần nào chưa; nếu chạy lại toàn bộ mà không có key hoặc cơ chế upsert phù hợp, hệ thống đích có thể nhận bản ghi trùng.
API trao đổi dữ liệu theo yêu cầu
API thường dùng khi một hệ thống cần hỏi hoặc gửi dữ liệu tại thời điểm phát sinh nghiệp vụ. Bên gọi tạo request, bên nhận xử lý và trả response cho biết kết quả. Mô hình này phù hợp với các thao tác cần phản hồi ngay, chẳng hạn tạo đơn, tra cứu tồn kho hoặc kiểm tra trạng thái.
API tạo liên kết thời gian khá chặt: bên gọi phải xử lý timeout, lỗi tạm thời và trường hợp bên nhận đang không sẵn sàng. Retry có thể cần thiết, nhưng request ghi dữ liệu phải có cơ chế chống tạo tác động lặp nếu cùng một request được gửi lại.
Message hoặc event đẩy thay đổi bất đồng bộ
Trong mô hình message/event, hệ thống nguồn phát thông điệp rồi tiếp tục công việc mà không cần chờ mọi hệ thống đích xử lý xong. Broker hoặc hàng đợi giữ và phân phối message; consumer đọc, xử lý rồi acknowledgement theo cơ chế của nền tảng.
Ưu điểm chính là giảm phụ thuộc thời gian giữa producer và consumer, đồng thời cho phép nhiều consumer nhận cùng một sự kiện. Đổi lại, dữ liệu ở các hệ thống có thể nhất quán theo thời gian thay vì đồng thời tuyệt đối. Consumer cũng phải chuẩn bị cho message lặp, xử lý chậm hoặc đến sai thứ tự nếu kiến trúc không đảm bảo ordering theo khóa liên quan.
CDC đọc thay đổi từ transaction log
Change data capture theo dõi các thay đổi insert, update và delete từ log giao dịch của cơ sở dữ liệu, chẳng hạn transaction log, WAL hoặc binlog tùy hệ quản trị. Thay vì quét lại toàn bảng, CDC lấy các thay đổi đã được database ghi nhận rồi chuyển chúng sang pipeline hoặc hệ thống đích.
CDC hữu ích khi cần lan truyền thay đổi với độ trễ thấp nhưng không muốn ứng dụng nguồn phải gọi API cho từng thay đổi. Giới hạn của CDC là nó nhìn thấy thay đổi ở mức dữ liệu: một update trong bảng chưa chắc tự mang đầy đủ ý nghĩa nghiệp vụ như một domain event. Schema change, thứ tự sự kiện và việc đọc lại từ vị trí cũ cũng phải được quản lý rõ ràng.
Đồng bộ đúng cần kiểm soát định danh, thứ tự và tính lặp an toàn
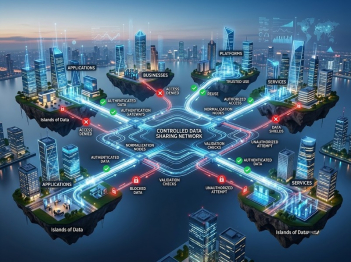
Trong hệ thống phân tán, “gửi đúng một lần” không phải giả định an toàn. Kết nối có thể mất sau khi bên đích đã ghi dữ liệu nhưng trước khi bên nguồn nhận xác nhận; bên nguồn vì thế gửi lại cùng một thao tác. Nếu đích tạo mới mỗi lần nhận, một lỗi mạng ngắn cũng có thể biến thành dữ liệu trùng.
Cách xử lý phổ biến là thiết kế idempotency: cùng một thao tác được xử lý nhiều lần nhưng trạng thái cuối không bị nhân đôi. Một business key hoặc idempotency key cho phép bên đích nhận ra request/sự kiện đã xử lý; upsert giúp cùng một bản ghi cập nhật đúng đối tượng thay vì tạo bản ghi mới.
Idempotency không giải quyết mọi vấn đề. Nếu phiên bản cũ đến sau phiên bản mới, việc “ghi lại an toàn” vẫn có thể làm dữ liệu quay về trạng thái cũ. Vì vậy luồng cập nhật thường cần thêm version, sequence hoặc timestamp đáng tin cậy để từ chối hoặc xử lý đúng update lỗi thời. Khi dùng message broker, phạm vi ordering cũng cần được hiểu chính xác: nhiều hệ thống chỉ đảm bảo thứ tự trong một partition hoặc một khóa, không phải trên toàn bộ luồng.
Mức nhất quán cũng là một lựa chọn kiến trúc. API đồng bộ có thể cho biết ngay thao tác bên đích thành công hay thất bại, trong khi event/message thường chấp nhận một khoảng trễ để đổi lấy khả năng tách rời và phục hồi tốt hơn. “Đồng bộ” vì vậy không đồng nghĩa mọi hệ thống luôn giống nhau tại cùng một mili-giây; điều quan trọng là trạng thái chênh lệch có được giới hạn, phát hiện và hội tụ theo yêu cầu nghiệp vụ hay không.
Khi tích hợp lỗi, hệ thống phải retry, cách ly và đối soát
Lỗi tích hợp cần được phân loại trước khi xử lý. Timeout, lỗi mạng hoặc dịch vụ tạm thời quá tải thường có thể retry; dữ liệu thiếu trường bắt buộc, sai mã tham chiếu hoặc vi phạm quy tắc nghiệp vụ thường không thể sửa bằng việc gửi lại nguyên trạng.
Với lỗi tạm thời, retry nên có giới hạn và khoảng chờ tăng dần để tránh biến sự cố ngắn thành “bão request”. Retry của thao tác ghi phải đi cùng idempotency; nếu không, mỗi lần thử lại có thể tạo thêm tác động tại hệ thống đích.
Với dữ liệu không thể xử lý tự động, message hoặc bản ghi nên được đưa sang khu vực cách ly hay dead-letter flow cùng lý do thất bại và thông tin truy vết. Sau khi dữ liệu hoặc cấu hình được sửa, hệ thống có thể phát lại đúng phần lỗi thay vì chạy lại toàn bộ luồng.
Monitoring chỉ cho biết pipeline có đang hoạt động; reconciliation kiểm tra dữ liệu có thực sự khớp hay không. Chẳng hạn, hệ thống có thể đối chiếu số đơn theo khoảng thời gian, business key, checksum hoặc trạng thái xử lý giữa nguồn và đích. Cách này phát hiện được các trường hợp pipeline “xanh” về mặt kỹ thuật nhưng một số bản ghi đã bị bỏ qua hoặc bị từ chối ở bước validation.
Cơ chế phù hợp phụ thuộc độ trễ, khối lượng và mức nhất quán cần thiết
Không có một phương thức tích hợp tốt nhất cho mọi hệ thống. Cơ chế nên được chọn từ yêu cầu dữ liệu trước, đặc biệt là độ mới cần thiết, khối lượng, cách hệ thống tương tác và khả năng phục hồi.
· Nếu dữ liệu chỉ cần cập nhật theo giờ hoặc theo ngày và khối lượng lớn: Batch/ETL thường đơn giản hơn vì có thể xử lý theo lô và kiểm soát lại toàn bộ tập dữ liệu
· Nếu một nghiệp vụ cần phản hồi ngay cho bên gọi: API phù hợp hơn vì request/response cho biết kết quả tại thời điểm thao tác
· Nếu nhiều hệ thống cần nhận cùng một thay đổi và không nên phụ thuộc trực tiếp vào nhau: Message/event phù hợp vì producer không phải gọi tuần tự từng consumer
· Nếu cần lan truyền thay đổi từ cơ sở dữ liệu với độ trễ thấp mà không sửa ứng dụng nguồn để phát sự kiện: CDC là lựa chọn đáng xem xét, miễn là có cách quản lý schema, replay và ý nghĩa nghiệp vụ của thay đổi
· Nếu yêu cầu vừa có giao dịch đồng bộ vừa có phân phối dữ liệu cho nhiều hệ thống: Có thể kết hợp API cho thao tác chính và event/CDC cho các luồng theo sau
Độ trễ càng thấp không tự động đồng nghĩa thiết kế càng tốt. Tích hợp gần thời gian thực thường làm tăng số sự kiện phải xử lý, nhu cầu quan sát hệ thống, xử lý thứ tự và chiến lược phục hồi. Batch chấp nhận dữ liệu cũ hơn nhưng dễ đối soát theo lô; API thể hiện rõ contract nghiệp vụ nhưng tạo phụ thuộc vào tính sẵn sàng của bên nhận; event giảm coupling nhưng đòi hỏi consumer xử lý eventual consistency; CDC lấy thay đổi hiệu quả từ database nhưng không tự thay thế logic nghiệp vụ.
Tiêu chí cuối cùng là chọn cơ chế đơn giản nhất vẫn đáp ứng được độ mới, độ chính xác và khả năng khôi phục mà luồng dữ liệu yêu cầu.
Tích hợp dữ liệu giữa các hệ thống được thực hiện bằng một chuỗi có kiểm soát: kết nối và lấy dữ liệu từ nguồn, ánh xạ định danh và schema, biến đổi và kiểm tra, truyền bằng batch/API/message/CDC, ghi sang đích rồi theo dõi và đối soát. Phần khó không nằm ở việc “chuyển được dữ liệu”, mà ở việc giữ đúng ý nghĩa của dữ liệu và xử lý đúng các tình huống lặp, sai thứ tự hoặc thất bại.
Vì vậy, một luồng tích hợp đáng tin cậy phải thiết kế cơ chế truyền cùng với data contract, idempotency, version/order và phục hồi lỗi. Phương thức truyền nên được chọn theo yêu cầu độ mới, khối lượng, mức coupling và tính nhất quán thay vì mặc định mọi dữ liệu đều cần đồng bộ theo thời gian thực.

GỬI Ý KIẾN BÌNH LUẬN
Bài xem nhiều