Năng lực xử lý dữ liệu có vai trò như thế nào?
Mục lục
- Năng lực xử lý dữ liệu là năng lực end-to-end của toàn chuỗi
- Tốc độ phải được nhìn bằng cả độ trễ và thông lượng
- Bộ nhớ, lưu trữ và mạng tạo ra các điểm nghẽn khác nhau
- Năng lực xử lý quyết định dữ liệu có được khai thác đúng thời điểm hay không
- Mở rộng năng lực chỉ hiệu quả khi giải quyết đúng điểm nghẽn
- Đánh giá năng lực xử lý phải bắt đầu từ workload và chỉ tiêu đầu ra
Năng lực xử lý dữ liệu chi phối độ trễ, thông lượng, khả năng mở rộng và mức dữ liệu có thể được khai thác đúng thời điểm trong hạ tầng số.
Trong hạ tầng số, năng lực xử lý dữ liệu đặt ra giới hạn về lượng công việc hệ thống có thể hoàn thành trong một khoảng thời gian và tốc độ trả kết quả cho người dùng hoặc ứng dụng. Khi năng lực xử lý thấp hơn tải thực tế, dữ liệu bắt đầu xếp hàng, độ trễ tăng và kết quả trở nên chậm so với thời điểm cần sử dụng. Khi năng lực được thiết kế cân bằng với luồng dữ liệu, hệ thống có thể duy trì thông lượng, phản hồi ổn định và mở rộng khối lượng khai thác.
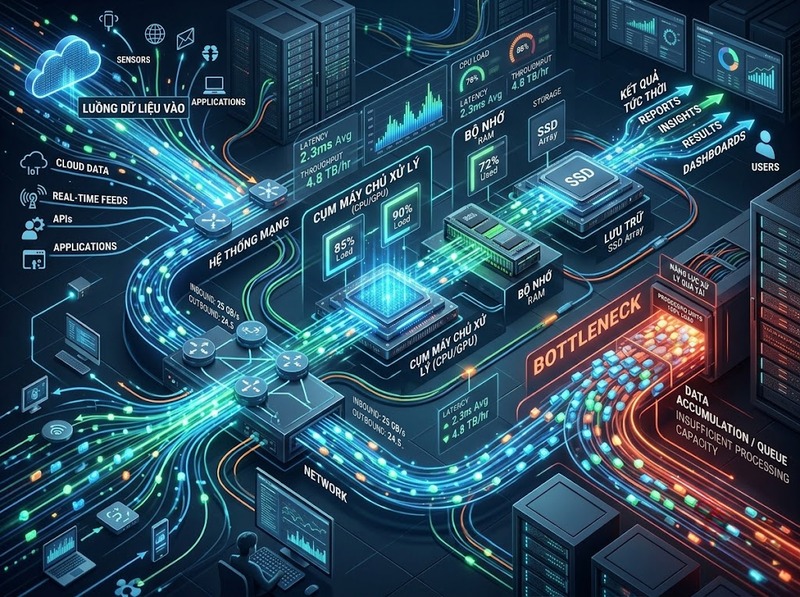
Không nên đồng nhất năng lực này với số lõi CPU, số GPU hay một thông số phần cứng đơn lẻ. Hiệu năng thực tế phụ thuộc toàn bộ đường đi của dữ liệu qua bộ xử lý, bộ nhớ, lưu trữ, mạng và phần mềm. NIST xác định volume, velocity, variety và variability là các đặc tính có thể buộc hệ thống dữ liệu lớn phải sử dụng kiến trúc có khả năng mở rộng để lưu trữ, thao tác và phân tích hiệu quả.
Năng lực xử lý dữ liệu là năng lực end-to-end của toàn chuỗi
Một hệ thống chỉ xử lý nhanh khi dữ liệu được cấp đủ nhanh cho tài nguyên tính toán và kết quả cũng được ghi, truyền hoặc phục vụ đủ nhanh. Vì vậy, năng lực hiệu dụng của hạ tầng là khả năng của toàn chuỗi xử lý, không phải tổng năng lực lý thuyết của từng linh kiện.
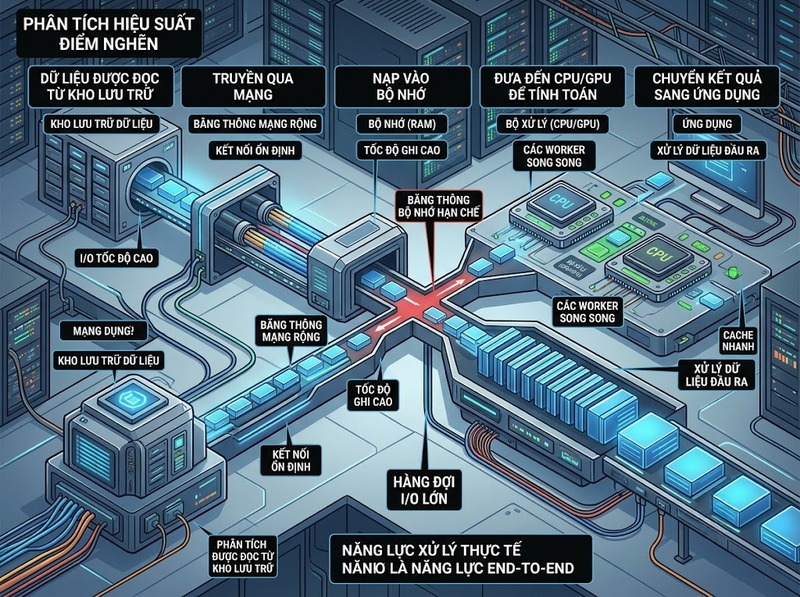
Dữ liệu thường phải đi qua nhiều lớp: đọc từ nguồn hoặc lưu trữ, truyền qua mạng, nạp vào bộ nhớ, thực hiện tính toán trên CPU, GPU hoặc bộ tăng tốc, rồi ghi hoặc trả kết quả. Nếu một lớp có thông lượng thấp hơn phần còn lại, lớp đó trở thành điểm nghẽn. CPU mạnh hơn không làm truy vấn nhanh hơn nếu dữ liệu vẫn phải chờ I/O; mạng nhanh hơn cũng không giải quyết được tác vụ đang bị giới hạn bởi tính toán.
Cơ chế này lý giải vì sao hai hệ thống có tài nguyên tính toán gần nhau vẫn có hiệu năng xử lý dữ liệu rất khác. Băng thông bộ nhớ, IOPS và thông lượng của lưu trữ, độ trễ mạng, mức song song, cách phân vùng dữ liệu, cache và hiệu quả của engine xử lý đều tác động đến lượng công việc hoàn thành trong cùng một khoảng thời gian.
Do đó, “năng lực xử lý dữ liệu” chỉ có ý nghĩa khi gắn với tải công việc cụ thể. Một hệ thống mạnh về tính toán số học chưa chắc mạnh với truy vấn phụ thuộc nhiều vào I/O; một cụm đạt thông lượng cao trong xử lý theo lô chưa chắc đáp ứng yêu cầu phản hồi rất thấp của dịch vụ tương tác.
Tốc độ phải được nhìn bằng cả độ trễ và thông lượng
Tốc độ xử lý có hai mặt khác nhau. Độ trễ (latency) cho biết một yêu cầu mất bao lâu từ lúc được tiếp nhận đến lúc có kết quả; thông lượng (throughput) cho biết hệ thống hoàn thành bao nhiêu đơn vị công việc trong một đơn vị thời gian. Tăng một đại lượng không bảo đảm đại lượng còn lại cùng cải thiện.
SPEC CPU 2026 thể hiện rõ sự khác biệt này. Các suite SPECspeed đánh giá thời gian hoàn thành một tác vụ, trong khi SPECrate đo throughput bằng nhiều bản công việc được thực hiện đồng thời. Vì vậy, “hoàn thành một việc nhanh” và “xử lý được nhiều việc trong cùng thời gian” phải được đánh giá riêng.
Khi tốc độ dữ liệu đi vào tiến gần tốc độ xử lý bền vững, hàng đợi bắt đầu tích tụ. Nếu chuỗi xử lý nhận 10 GB dữ liệu mỗi giây nhưng chỉ xử lý ổn định 8 GB/s, phần chưa xử lý tăng 2 GB mỗi giây; sau 10 phút, backlog đã tăng khoảng 1,2 TB. Với hệ thống streaming hoặc giao dịch, backlog còn làm độ trễ tiếp tục tăng dù tài nguyên đang hoạt động gần hết công suất.
Vì vậy, giá trị trung bình chưa đủ để đánh giá các workload nhạy cảm với thời gian. Với dịch vụ tương tác hoặc thời gian thực, p95 hay p99 latency cho biết nhóm yêu cầu chậm nhất có vượt giới hạn phục vụ hay không. Với xử lý theo lô, thời gian hoàn thành job và thông lượng bền vững thường quan trọng hơn. Một cấu hình có thể đáp ứng tốt workload này nhưng không phù hợp với workload khác.
Bộ nhớ, lưu trữ và mạng tạo ra các điểm nghẽn khác nhau
CPU hoặc GPU chỉ tạo ra hiệu năng khi nhận được dữ liệu đúng tốc độ. Nếu dữ liệu nằm trên lớp lưu trữ có thông lượng thấp, phải truyền qua mạng đang nghẽn hoặc liên tục chờ bộ nhớ, tài nguyên tính toán sẽ có thời gian chờ dù công suất lý thuyết rất lớn.
Mỗi lớp vì thế cần metric riêng. CPU/GPU có thể được quan sát bằng thời gian tính toán, số tác vụ mỗi giây hoặc các chỉ số chuyên biệt cho workload; bộ nhớ cần băng thông và độ trễ; lưu trữ cần IOPS, throughput và latency; mạng cần bandwidth, latency và mức sử dụng đường truyền. Không thể cộng các chỉ số này thành một “điểm năng lực” chung, vì nút thắt thực tế phụ thuộc loại công việc đang chạy.
Đó cũng là lý do một lần nâng cấp phần cứng có thể gần như không cải thiện kết quả. Nếu truy vấn bị giới hạn bởi tốc độ đọc, tăng số lõi chỉ khiến nhiều luồng cùng chờ I/O. Ngược lại, khi dữ liệu đã nằm trong bộ nhớ và phép tính chiếm phần lớn thời gian, tăng tốc lưu trữ có thể ít tác dụng hơn tăng năng lực tính toán hoặc cải thiện cách thực thi.
Muốn nâng năng lực thực, cần tìm nơi thời gian bị tiêu tốn và nơi hàng đợi hình thành. Mức sử dụng tài nguyên, queue depth, thời gian chờ I/O, cache miss, network saturation và thời gian của từng stage giúp phân biệt một hệ thống thực sự thiếu compute với một hệ thống có compute nhưng không được cung cấp dữ liệu đủ nhanh.
Năng lực xử lý quyết định dữ liệu có được khai thác đúng thời điểm hay không
Dữ liệu không chỉ cần được lưu mà còn phải được xử lý trước thời điểm kết quả mất giá trị sử dụng. NIST phân biệt dữ liệu chuyển động với dữ liệu ở trạng thái nghỉ và chỉ ra rằng yêu cầu xử lý thời gian thực hoặc gần thời gian thực có thể dẫn đến kiến trúc khác. Các processing framework cho dữ liệu lớn cũng trải từ xử lý batch đến streaming để đáp ứng những yêu cầu thời gian khác nhau.
Trong phân tích theo lô, năng lực xử lý quyết định một job có kết thúc trong cửa sổ vận hành hay không. Nếu báo cáo phải hoàn thành trước 6 giờ sáng nhưng pipeline chỉ xong lúc 9 giờ, dữ liệu vẫn tồn tại đầy đủ nhưng kết quả đã trễ so với nhu cầu sử dụng. Với luồng dữ liệu thời gian thực như telemetry hoặc phát hiện giao dịch bất thường, độ trễ có thể biến một tín hiệu còn khả năng hành động thành thông tin chỉ còn giá trị hậu kiểm.
Các benchmark dữ liệu cũng gắn hiệu năng với workload và quy mô thay vì chỉ đo sức mạnh phần cứng. TPC-H sử dụng QphH@Size để phản ánh quy mô cơ sở dữ liệu, khả năng xử lý truy vấn và throughput khi có nhiều luồng đồng thời. TPC đồng thời lưu ý rằng so sánh benchmark ở các kích thước cơ sở dữ liệu khác nhau có thể gây hiểu nhầm vì hiệu năng không nhất thiết thay đổi tỷ lệ thuận với kích thước dữ liệu.
Tuy nhiên, năng lực xử lý không tự làm dữ liệu chính xác hơn và không bảo đảm phân tích tạo ra quyết định đúng. Vai trò của nó là bảo đảm dữ liệu có thể được chuyển thành kết quả trong giới hạn thời gian, tải và quy mô mà hệ thống yêu cầu. Chất lượng dữ liệu và chất lượng logic phân tích vẫn là các điều kiện riêng.
Mở rộng năng lực chỉ hiệu quả khi giải quyết đúng điểm nghẽn
Có hai hướng mở rộng phổ biến: tăng tài nguyên trên một node và phân tán công việc ra nhiều node. Scale-up thường đơn giản hơn về điều phối nhưng bị giới hạn bởi khả năng mở rộng của một máy. Scale-out có thể tăng thông lượng bằng xử lý song song, đổi lại hệ thống phải chịu thêm chi phí truyền dữ liệu, đồng bộ, phân vùng và điều phối.
Vì thế, thêm node không đồng nghĩa tốc độ tăng tuyến tính. Nếu workload phải trao đổi nhiều dữ liệu giữa các node, thời gian dành cho network và synchronization có thể lấy đi một phần lợi ích từ năng lực tính toán bổ sung. Khi dữ liệu phân vùng không đều, một số worker có thể hoàn thành sớm trong khi worker giữ partition lớn trở thành straggler và kéo dài thời gian của toàn job.
Xử lý theo lô và xử lý luồng cũng tạo trade-off khác nhau. Batch có thể gom nhiều bản ghi để tăng thông lượng và khai thác tài nguyên hiệu quả hơn, nhưng thời gian chờ gom batch làm tăng độ trễ. Streaming giảm thời gian chờ nhưng đòi hỏi hệ thống theo kịp tốc độ sự kiện, quản lý trạng thái và xử lý backpressure khi các stage phía sau không tiêu thụ dữ liệu đủ nhanh. NIST cũng phân loại processing framework theo batch và streaming vì hai kiểu công việc đòi hỏi cách tổ chức xử lý khác nhau.
Mục tiêu mở rộng vì vậy không phải đẩy mức sử dụng phần cứng lên cao nhất, mà là tăng năng lực tại stage đang giới hạn mức dịch vụ (SLA). Sau một lần nâng cấp, điểm nghẽn có thể chuyển từ compute sang bộ nhớ, I/O hoặc mạng; capacity planning phải được đánh giá lại theo trạng thái mới của toàn pipeline.
Đánh giá năng lực xử lý phải bắt đầu từ workload và chỉ tiêu đầu ra
Không có một con số duy nhất cho biết hạ tầng “đủ mạnh”. Một hệ thống có thể đạt hiệu năng CPU cao nhưng không phù hợp với data warehouse, hoặc đạt thông lượng inference cao nhưng không đáp ứng độ trễ của dịch vụ trực tuyến. Các benchmark chuyên ngành vì thế dùng những workload và metric khác nhau: SPEC CPU 2026 tách speed với rate, TPC-H đánh giá query performance theo quy mô dữ liệu, còn MLPerf Inference sử dụng các scenario với metric thông lượng và các yêu cầu về latency để đánh giá hệ thống suy luận máy học.
Một đánh giá thực tế nên bắt đầu từ các biến có thể đo được:
· Tải vào: Khối lượng dữ liệu, tốc độ phát sinh, kích thước bản ghi và mức burst
· Mẫu xử lý: Batch, streaming, truy vấn tương tác, giao dịch hay inference
· Mức đồng thời: Số job, query, session hoặc request cùng tranh chấp tài nguyên
· Mục tiêu dịch vụ: Thông lượng bền vững, thời gian hoàn thành, p95/p99 latency và cửa sổ xử lý
· Điểm nghẽn: Compute, memory, storage, network hay overhead phần mềm
· Khả năng mở rộng: Hiệu năng thay đổi thế nào khi tăng dữ liệu, người dùng hoặc số node
· Hiệu quả tài nguyên: Chi phí và năng lượng cho mỗi đơn vị công việc hoàn thành
Hạ tầng có năng lực phù hợp khi giữ được thông lượng cao hơn tải cần phục vụ trong điều kiện đỉnh, đồng thời đáp ứng giới hạn độ trễ hoặc thời gian hoàn thành và có khoảng dự phòng cho biến động. Không tồn tại một tỷ lệ dự phòng đúng cho mọi hệ thống; mức cần thiết phụ thuộc độ biến động của tải, tốc độ bổ sung tài nguyên và mức gián đoạn có thể chấp nhận.
Benchmark cuối cùng phải đại diện cho workload thật. Kết quả của một bài test thiên về tính toán không thể thay cho benchmark truy vấn dữ liệu, còn chỉ số throughput không thể tự mình chứng minh rằng một dịch vụ có yêu cầu latency thấp sẽ phản hồi đủ nhanh.
Năng lực xử lý dữ liệu là một giới hạn kỹ thuật trực tiếp đối với tốc độ và khả năng khai thác dữ liệu trong hạ tầng số. Nó quyết định hệ thống có theo kịp dòng dữ liệu, hoàn thành công việc trong cửa sổ yêu cầu và mở rộng tải mà không tạo backlog hoặc độ trễ vượt ngưỡng hay không.
Giới hạn này nằm ở toàn bộ chuỗi xử lý chứ không riêng CPU hay GPU. Việc cải thiện phải bắt đầu bằng đo tải công việc qua độ trễ, thông lượng, mức đồng thời và quy mô dữ liệu, sau đó xác định stage gây nghẽn trước khi bổ sung tài nguyên. Khi compute, memory, storage, network và phần mềm được cân bằng theo tải thực, năng lực xử lý mới chuyển thành tốc độ phản hồi và khả năng khai thác dữ liệu có ý nghĩa.

GỬI Ý KIẾN BÌNH LUẬN
Bài xem nhiều