Hạ tầng công nghệ và chuyển đổi số liên hệ thế nào?
Mục lục
- Hạ tầng hiện có đặt giới hạn kỹ thuật cho chuyển đổi số ra sao?
- Năng lực tính toán, mạng và lưu trữ chi phối tốc độ và quy mô thế nào?
- Khả năng tích hợp và nền tảng dữ liệu quyết định mức kết nối đến đâu?
- Bảo mật, tính sẵn sàng và vận hành ảnh hưởng khả năng đưa dịch vụ số vào thực tế thế nào?
- Khi nào hệ thống legacy trở thành điểm nghẽn chuyển đổi số?
- Đánh giá hạ tầng sẵn sàng cho chuyển đổi số bằng những chỉ số nào?
Hạ tầng hiện có quyết định tốc độ, quy mô và mức rủi ro khi triển khai chuyển đổi số. Mức độ sẵn sàng nên được đánh giá theo workload, tích hợp, dữ liệu, bảo mật, khả năng phục hồi và vận hành.
Hạ tầng công nghệ trong chuyển đổi số không chỉ là máy chủ, đường truyền hay dung lượng lưu trữ. Nó còn bao gồm lớp nền tảng chạy ứng dụng, cơ chế tích hợp, nền tảng dữ liệu, quản lý danh tính và truy cập, sao lưu - khôi phục, giám sát và tự động hóa vận hành. Một sáng kiến số mới gần như luôn phải chạy trên, lấy dữ liệu từ hoặc kết nối với các lớp này.
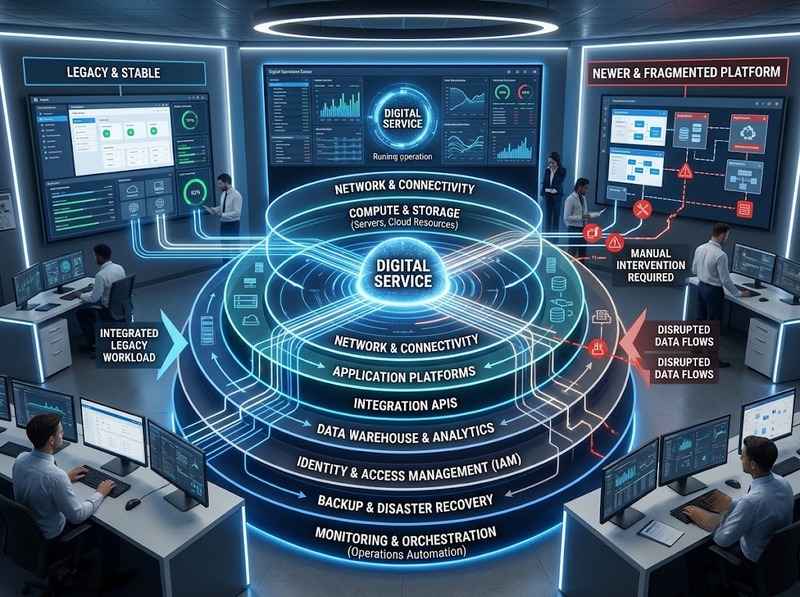
Vì vậy, câu hỏi hữu ích không phải là hạ tầng “cũ hay mới”, mà là hạ tầng hiện tại có phù hợp với workload và mức dịch vụ mục tiêu hay không. Một hệ thống lâu năm vẫn có thể tiếp tục phục vụ nếu ổn định, có giao diện tích hợp phù hợp, được hỗ trợ và đáp ứng yêu cầu bảo mật - phục hồi. Ngược lại, một nền tảng mới vẫn có thể trở thành điểm nghẽn nếu kiến trúc phân mảnh, dữ liệu khó dùng hoặc quy trình vận hành còn thủ công.
Hạ tầng hiện có đặt giới hạn kỹ thuật cho chuyển đổi số ra sao?
Hạ tầng hiện có tạo ra một “trần kỹ thuật” cho những gì tổ chức có thể triển khai ngay. Mỗi dịch vụ số mới đều cần tài nguyên tính toán, lưu trữ, kết nối mạng, dữ liệu, quyền truy cập, cơ chế phục hồi và một cách vận hành đủ ổn định. Nếu một trong các mắt xích này không đáp ứng, dự án không nhất thiết phải dừng, nhưng thường phải giảm phạm vi, bổ sung lớp trung gian, tăng thao tác thủ công hoặc xử lý hạ tầng trước khi mở rộng.
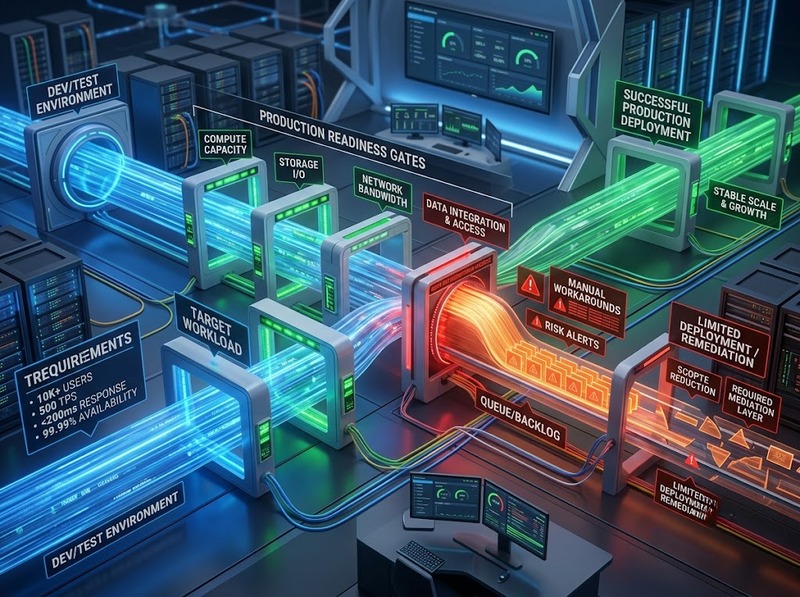
Cơ chế ảnh hưởng có thể nhìn theo chuỗi yêu cầu workload → năng lực hạ tầng → khoảng cách kỹ thuật → hệ quả triển khai. Chẳng hạn, một ứng dụng cần phản hồi gần thời gian thực nhưng dữ liệu nguồn chỉ được đồng bộ theo lô vài giờ một lần thì vấn đề không nằm ở giao diện ứng dụng. Khoảng cách nằm ở luồng tích hợp và dữ liệu. Tương tự, một quy trình có thể chạy tốt với vài chục người dùng thử nghiệm nhưng trở nên chậm khi đưa vào toàn doanh nghiệp nếu compute, storage I/O hoặc network không có đủ headroom ở giờ cao điểm.
Điều này giải thích vì sao hạ tầng ảnh hưởng đồng thời đến bốn biến của chuyển đổi số: tốc độ triển khai, phạm vi có thể số hóa, khả năng mở rộng và mức rủi ro vận hành. Hạ tầng có API rõ ràng, dữ liệu nhất quán, khả năng mở rộng và cơ chế triển khai tự động thường giảm số bước phải xử lý cho mỗi thay đổi. Hạ tầng phân mảnh hoặc khó quan sát khiến cùng một thay đổi phải đi qua nhiều tích hợp riêng, kiểm tra thủ công và phương án dự phòng, làm lead time dài hơn.
Tuy nhiên, hạ tầng tốt không đồng nghĩa chuyển đổi số chắc chắn thành công. Nó là điều kiện kỹ thuật cần để chiến lược, quy trình và mô hình vận hành mới có thể thực thi ở quy mô thực tế. Nếu mục tiêu kinh doanh, cách tổ chức công việc hoặc năng lực sử dụng dữ liệu chưa phù hợp, đầu tư thêm hạ tầng không tự tạo ra giá trị chuyển đổi.
Năng lực tính toán, mạng và lưu trữ chi phối tốc độ và quy mô thế nào?
Một thử nghiệm nhỏ có thể chạy ổn trên hạ tầng hiện tại nhưng điều đó chưa chứng minh hệ thống đủ sức vận hành ở production. Khi số người dùng, số giao dịch, lượng dữ liệu hoặc số kết nối đồng thời tăng, bottleneck thường xuất hiện ở một trong ba lớp: compute, storage hoặc network. Lớp chậm nhất sẽ quyết định throughput và latency của toàn chuỗi.
Với compute, cần nhìn CPU, memory, khả năng xử lý song song và headroom ở tải đỉnh thay vì chỉ xem cấu hình danh nghĩa. Với storage, dung lượng chỉ là một phần; IOPS, throughput và độ trễ truy xuất mới có thể quyết định tốc độ của workload giao dịch hoặc phân tích. Với network, băng thông, latency, packet loss và đường kết nối giữa các hệ thống ảnh hưởng trực tiếp đến các ứng dụng phụ thuộc API, dữ liệu thời gian thực hoặc kiến trúc phân tán.
Các chỉ số nên gắn với hành vi thực tế của dịch vụ. Average latency có thể che khuất những phiên rất chậm, nên p95 hoặc p99 thường hữu ích hơn khi cần biết trải nghiệm ở phần đuôi phân phối. Peak utilization cho biết hạ tầng còn bao nhiêu khoảng dự phòng trước khi chạm giới hạn. Throughput cho biết hệ thống xử lý được bao nhiêu yêu cầu hoặc giao dịch trong một đơn vị thời gian. Không có một ngưỡng CPU, latency hay utilization duy nhất phù hợp cho mọi workload; hệ thống thanh toán, báo cáo nội bộ và xử lý batch có yêu cầu khác nhau.
Do đó, capacity planning cho chuyển đổi số nên bắt đầu bằng tải mục tiêu và mức dịch vụ mong muốn, sau đó mới đối chiếu với baseline hiện tại. Nếu khoảng cách chỉ nằm ở capacity, scale-up, scale-out hoặc điều chỉnh tài nguyên có thể đủ. Nếu bottleneck đến từ coupling kiến trúc, dữ liệu hoặc cách triển khai, tăng cấu hình phần cứng chỉ trì hoãn vấn đề chứ không loại bỏ nguyên nhân.
Khả năng tích hợp và nền tảng dữ liệu quyết định mức kết nối đến đâu?
Dịch vụ số hiếm khi hoạt động độc lập. Một quy trình đặt hàng, chăm sóc khách hàng hay phê duyệt điện tử thường phải đọc dữ liệu từ hệ thống hiện hữu, ghi kết quả về system of record và kích hoạt các bước ở những ứng dụng khác. Vì vậy, khả năng tích hợp quyết định tổ chức có thể số hóa end-to-end hay chỉ tạo thêm một lớp giao diện mới phía trên các quy trình rời rạc.
Khi hệ thống có API ổn định, hợp đồng dữ liệu rõ và cơ chế xác thực nhất quán, ứng dụng mới có thể kết nối theo cách lặp lại được. Ngược lại, tích hợp point-to-point, phụ thuộc file thủ công hoặc batch không kiểm soát làm tăng coupling. Mỗi thay đổi ở một hệ thống có thể kéo theo sửa nhiều kết nối khác, kiểm thử hồi quy lớn hơn và nguy cơ sai lệch dữ liệu cao hơn. Chi phí kỹ thuật vì thế tăng theo số sáng kiến, dù từng ứng dụng riêng lẻ không quá phức tạp.
Nền tảng dữ liệu cũng tạo ra một ràng buộc tương tự. Nếu cùng một khách hàng có nhiều định danh, dữ liệu không có owner rõ, độ trễ đồng bộ dài hoặc chất lượng dữ liệu không được theo dõi, việc thêm dashboard, AI hay tự động hóa có thể khuếch đại sai lệch thay vì tạo giá trị. Những chỉ số như API error rate, thời gian đồng bộ, tỷ lệ đối soát thủ công, data freshness hoặc số lỗi chất lượng dữ liệu giúp biến vấn đề “khó tích hợp” thành tín hiệu có thể quan sát.
Microservices, API-first hay cloud không phải đáp án mặc định. Một kiến trúc đơn giản, ít thay đổi nhưng có giao diện ổn định có thể phù hợp hơn việc chia nhỏ hệ thống chỉ để theo xu hướng. Điều cần đánh giá là luồng dữ liệu và dependency quan trọng có thể thay đổi, kiểm thử và phục hồi với mức ma sát chấp nhận được hay không.
Bảo mật, tính sẵn sàng và vận hành ảnh hưởng khả năng đưa dịch vụ số vào thực tế thế nào?
Một giải pháp “chạy được” về chức năng chưa chắc đã “vận hành được” ở production. Khi quy trình số trở thành kênh phục vụ khách hàng hoặc hệ thống nội bộ quan trọng, yêu cầu không còn dừng ở việc xử lý đúng. Tổ chức còn phải kiểm soát ai được truy cập, phát hiện sự cố, khôi phục dịch vụ, theo dõi trạng thái và triển khai thay đổi mà không tạo ra rủi ro quá mức.
Ở lớp bảo mật, các cơ chế quản lý danh tính, phân quyền, MFA, quản lý tài khoản đặc quyền, vá lỗi và ghi log ảnh hưởng trực tiếp đến khả năng mở rộng dịch vụ số. NIST Cybersecurity Framework và ISO/IEC 27001 có thể được dùng làm khung tham chiếu để tổ chức các năng lực kiểm soát và quản lý rủi ro. Tuy nhiên, việc “tuân theo khung” không thay thế việc xác định control nào cần cho từng workload và mức rủi ro cụ thể.
Ở lớp phục hồi, availability, RTO và RPO chuyển yêu cầu kinh doanh thành tiêu chí kỹ thuật. Ví dụ, nếu một dịch vụ đặt mục tiêu availability 99,9% trong một tháng 30 ngày, tổng thời gian không sẵn sàng tương ứng khoảng 43,2 phút; với 99,99%, con số còn khoảng 4,32 phút. Đây là phép quy đổi từ mục tiêu dịch vụ, không phải ngưỡng bắt buộc cho mọi hệ thống. Cách tính thời gian bảo trì có được loại trừ hay không còn phụ thuộc định nghĩa SLA. Tương tự, RTO xác định thời gian khôi phục mục tiêu, còn RPO xác định mức mất dữ liệu theo thời gian mà tổ chức chấp nhận; giá trị của hai chỉ số chỉ có ý nghĩa khi quy trình backup và recovery được kiểm thử thực tế.
Khả năng vận hành là lớp thường bị bỏ sót. Nếu không có monitoring, log tập trung, alert có chất lượng và cơ chế rollback, thời gian chẩn đoán sự cố sẽ dài ngay cả khi ứng dụng được thiết kế tốt. Nếu mỗi lần release phải cấu hình thủ công nhiều môi trường, rủi ro sai lệch cấu hình và change failure tăng. Tự động hóa triển khai, infrastructure-as-code hoặc CI/CD chỉ tạo giá trị khi chúng làm giảm biến thiên và cho phép lặp lại thao tác an toàn; triển khai công cụ nhưng vẫn giữ quy trình kiểm soát mơ hồ sẽ không giải quyết được vấn đề.
Khi nào hệ thống legacy trở thành điểm nghẽn chuyển đổi số?
“Legacy” không nên được hiểu đơn giản là hệ thống đã dùng nhiều năm. Một hệ thống cũ nhưng ổn định, còn được hỗ trợ, có interface rõ, đáp ứng yêu cầu bảo mật và phục hồi vẫn có thể tiếp tục làm system of record. Điểm nghẽn xuất hiện khi hệ thống làm cho mỗi thay đổi mới trở nên quá chậm, quá rủi ro hoặc quá khó kiểm soát so với yêu cầu chuyển đổi.
Các dấu hiệu đáng chú ý gồm dependency chặt khiến một thay đổi nhỏ phải sửa nhiều thành phần; không có API nên phải dùng file hoặc thao tác tay; nền tảng hết hỗ trợ khiến vá lỗi khó thực hiện; backup có nhưng chưa chứng minh khả năng restore; hoặc release cần nhiều bước thủ công và thời gian dừng dịch vụ. Những dấu hiệu này có thể đo bằng lead time thay đổi, số bước thủ công, tỷ lệ lỗi tích hợp, thời gian phục hồi, số dependency không được hỗ trợ hoặc tần suất phải đối soát dữ liệu.
Cách xử lý vì thế không nhất thiết là thay toàn bộ. Nếu core system còn ổn định nhưng khó kết nối, có thể giữ lại và tạo lớp API hoặc integration phù hợp. Nếu nền tảng còn phù hợp về chức năng nhưng khó vận hành, replatform có thể giảm ma sát. Khi cấu trúc bên trong ngăn thay đổi thường xuyên, refactor một miền chức năng quan trọng có thể hợp lý. Chỉ khi constraint mang tính nền tảng — chẳng hạn không thể đáp ứng control, khả năng phục hồi hoặc tốc độ thay đổi cần thiết — thay thế mới trở thành lựa chọn đáng cân nhắc.
Trade-off quan trọng là chi phí hiện đại hóa so với chi phí ma sát tiếp tục tích lũy. Big-bang replacement có thể loại bỏ nhiều nợ kỹ thuật nhưng đồng thời tăng migration risk và phạm vi thay đổi. Hiện đại hóa từng phần cho phép giảm rủi ro bằng cách xử lý constraint có tác động lớn nhất trước. Vì vậy, tuổi đời của công nghệ không nên là tiêu chí ưu tiên; mức độ nó cản workload mục tiêu mới là tiêu chí có giá trị hơn.
Đánh giá hạ tầng sẵn sàng cho chuyển đổi số bằng những chỉ số nào?
Đánh giá readiness nên chuyển từ câu hỏi “hạ tầng có hiện đại không?” sang “hạ tầng hiện tại có đáp ứng workload mục tiêu với mức dịch vụ và rủi ro chấp nhận được không?”. Cách làm này buộc mỗi nhận định phải gắn với baseline và requirement cụ thể.
Nhóm chỉ số nào cần đo theo workload?
|
Nhóm năng lực |
Chỉ số có thể theo dõi |
Câu hỏi cần trả lời |
|
Capacity và hiệu năng |
Peak CPU/memory, storage IOPS/throughput, network throughput, p95/p99 latency, capacity headroom |
Tải mục tiêu có làm hệ thống chạm bottleneck hoặc suy giảm trải nghiệm không? |
|
Tích hợp và dữ liệu |
API availability/error rate, sync delay, data freshness, số bước đối soát thủ công, lỗi chất lượng dữ liệu |
Quy trình số có lấy và cập nhật dữ liệu đủ nhanh, đủ nhất quán không? |
|
Tính sẵn sàng và phục hồi |
Availability, MTTR, RTO, RPO, kết quả restore test |
Khi sự cố xảy ra, dịch vụ và dữ liệu có phục hồi trong giới hạn chấp nhận được không? |
|
Bảo mật |
Coverage của MFA/IAM, kiểm soát tài khoản đặc quyền, trạng thái vá lỗi, logging/alert coverage |
Workload mới có thể mở rộng mà vẫn giữ kiểm soát truy cập và khả năng phát hiện sự cố không? |
|
Vận hành và thay đổi |
Deployment lead time, change failure rate, rollback time, automation/monitoring coverage |
Mỗi thay đổi có thể được phát hành và khôi phục một cách lặp lại, có kiểm soát không? |
Các chỉ số này không tạo ra một “điểm sẵn sàng” phổ quát. Một hệ thống có availability rất cao nhưng không có interface tích hợp phù hợp vẫn có thể chặn sáng kiến số. Ngược lại, một workload nội bộ ít quan trọng có thể chấp nhận RTO dài hơn dịch vụ khách hàng 24/7. Threshold phải xuất phát từ criticality, user journey, khối lượng giao dịch, quy định áp dụng và mức rủi ro tổ chức chấp nhận.
Ưu tiên nâng cấp hạ tầng theo điểm nghẽn như thế nào?
1. Xác định workload mục tiêu — Làm rõ số người dùng, lưu lượng, dependency, dữ liệu, mức dịch vụ, yêu cầu bảo mật và phục hồi
2. Đo baseline hiện tại — Thu thập cùng nhóm chỉ số trên ở giờ bình thường, giờ cao điểm và trong các tình huống recovery quan trọng
3. Xác định khoảng cách và mức ảnh hưởng — Phân biệt gap nào chặn triển khai, gap nào chỉ làm giảm hiệu quả và gap nào chưa đáng xử lý
4. Chọn remediation nhỏ nhất đủ loại bỏ constraint — Ưu tiên scale, tối ưu cấu hình, bổ sung integration/control/automation hoặc hiện đại hóa thành phần trước khi mặc định thay toàn bộ
Logic này giúp tránh hai cực đoan: cố triển khai sáng kiến số trên nền tảng không đủ điều kiện, hoặc nâng cấp toàn bộ hạ tầng trước khi biết bottleneck nằm ở đâu. Mục tiêu không phải đạt một kiến trúc “hiện đại nhất”, mà tạo đủ năng lực kỹ thuật để workload ưu tiên có thể được triển khai, mở rộng và vận hành với rủi ro đã được kiểm soát.
Hạ tầng công nghệ hiện có ảnh hưởng trực tiếp đến khả năng chuyển đổi số vì nó quyết định workload mới có thể chạy, kết nối, mở rộng, phục hồi và được vận hành an toàn đến mức nào. Điểm quyết định không nằm ở việc hạ tầng mới hay cũ, on-premises hay cloud, mà ở mức độ fit-for-purpose so với yêu cầu của sáng kiến số cụ thể.
Cách đánh giá đáng tin cậy là bắt đầu từ workload mục tiêu, đo baseline bằng các chỉ số kỹ thuật phù hợp, xác định gap và xử lý constraint có tác động lớn nhất. Hạ tầng tốt tạo điều kiện cho chuyển đổi diễn ra nhanh và ít ma sát hơn; nhưng nó vẫn chỉ là nền tảng kỹ thuật, không thay thế các điều kiện khác cần để chuyển đổi số tạo ra kết quả thực tế.

GỬI Ý KIẾN BÌNH LUẬN
Bài xem nhiều