Thiết kế hạ tầng số để mở rộng như thế nào?
Mục lục
- Thiết kế hạ tầng số nên dựa trên khả năng mở rộng nào?
- Kiến trúc cần được phân lớp và tách thành phần như thế nào?
- Dữ liệu phải được thiết kế ra sao để không trở thành điểm nghẽn?
- Autoscaling và tự động hóa nên được thiết kế theo nguyên tắc nào?
- Khả năng mở rộng phải đi cùng độ tin cậy và quan sát như thế nào?
- Làm thế nào để thiết kế hạ tầng có thể thay đổi mà không phải tái xây dựng?
Thiết kế hạ tầng số có khả năng mở rộng cần bắt đầu từ kiến trúc phân lớp, ưu tiên mở rộng ngang, tự động hóa tài nguyên, tách các thành phần có tải biến động và thiết kế dữ liệu, quan sát hệ thống, bảo mật theo cùng một mô hình tăng trưởng
Khi nhu cầu người dùng tăng, hạ tầng số không chỉ cần thêm máy chủ. Một kiến trúc có khả năng mở rộng phải cho phép tăng năng lực xử lý theo tải mà không buộc toàn bộ hệ thống phải thay đổi cùng lúc. Vì vậy, trọng tâm của thiết kế hạ tầng số là xác định thành phần nào cần mở rộng, mở rộng theo chiều nào, ngưỡng nào kích hoạt mở rộng và giới hạn nào khiến kiến trúc hiện tại không còn phù hợp
Thiết kế hạ tầng số nên dựa trên khả năng mở rộng nào?
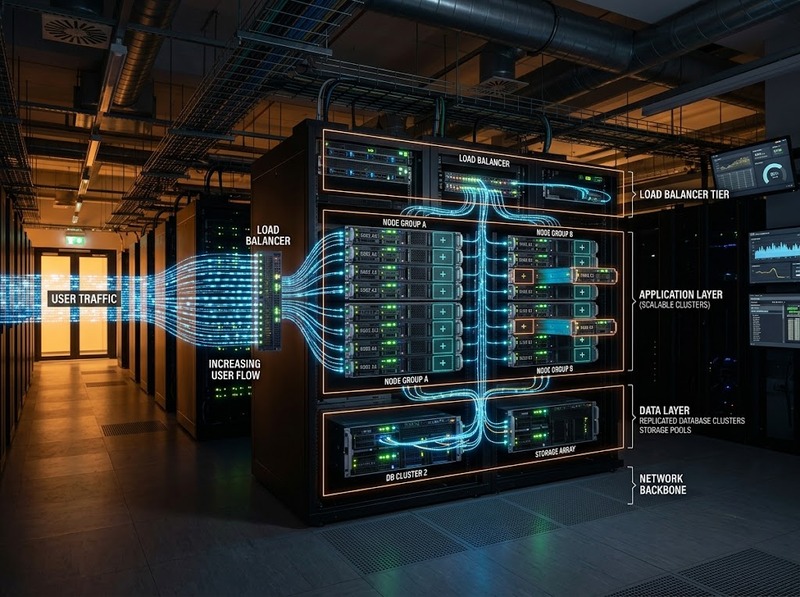
Khả năng mở rộng là khả năng tăng năng lực của hệ thống khi tải tăng mà vẫn duy trì các mục tiêu về hiệu năng, độ sẵn sàng và chi phí trong phạm vi chấp nhận được. Có hai hướng chính:
· Mở rộng dọc: Tăng CPU, RAM, lưu trữ hoặc năng lực của một máy chủ
· Mở rộng ngang: Thêm nhiều instance hoặc node để phân phối tải
Mở rộng dọc thường đơn giản hơn nhưng bị giới hạn bởi cấu hình tối đa của một máy. Khi hệ thống phụ thuộc quá nhiều vào một máy chủ lớn, việc tăng tải có thể nhanh chóng trở thành điểm nghẽn.
Mở rộng ngang phù hợp hơn với các dịch vụ có nhu cầu tăng theo lưu lượng. Bộ cân bằng tải phân phối request cho nhiều instance, trong khi cơ chế autoscaling có thể bổ sung hoặc thu hồi instance theo tín hiệu tải.
Vì vậy, kiến trúc mở rộng tốt thường ưu tiên các thành phần có thể scale độc lập. Một dịch vụ xử lý API, hàng đợi tác vụ và lớp xử lý dữ liệu không nhất thiết phải tăng tài nguyên cùng một tỷ lệ. Tách được các miền tải giúp hệ thống sử dụng tài nguyên sát với nhu cầu thực tế hơn.
Điểm cần đo không chỉ là số lượng máy chủ. Các chỉ số như requests/giây, độ trễ p95 hoặc p99, CPU, bộ nhớ, độ dài hàng đợi, tỷ lệ lỗi và mức sử dụng kết nối giúp xác định hệ thống đang thiếu năng lực ở đâu và khi nào cần mở rộng.
Kiến trúc cần được phân lớp và tách thành phần như thế nào?
Một hạ tầng có khả năng mở rộng nên hạn chế phụ thuộc cứng giữa các thành phần. Mục tiêu là khi một lớp tăng tải, chỉ lớp đó phải tăng năng lực nếu điều kiện cho phép.
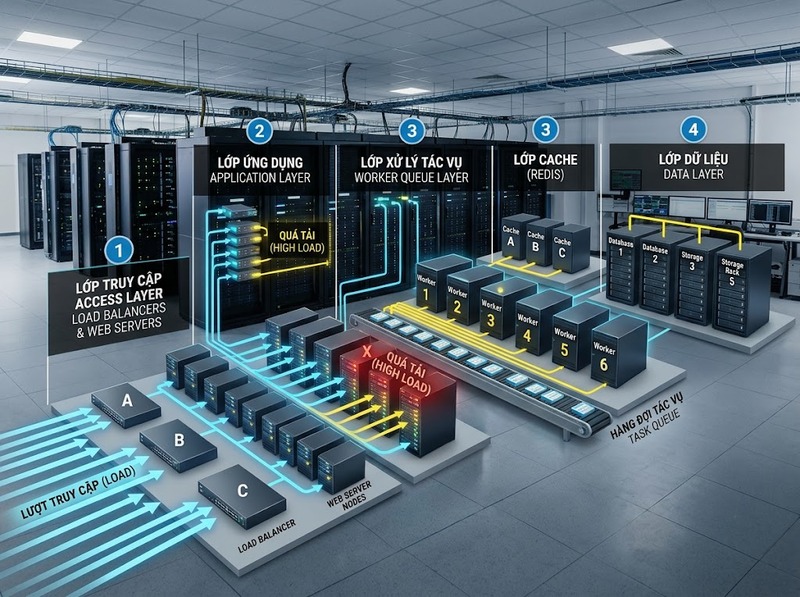
Một mô hình thường gồm:
1. Lớp truy cập: DNS, CDN, API gateway hoặc load balancer phân phối lưu lượng
2. Lớp ứng dụng: Các service hoặc instance xử lý nghiệp vụ
3. Lớp xử lý bất đồng bộ: Queue và worker dành cho tác vụ có thể tách khỏi request trực tiếp
4. Lớp dữ liệu: Cơ sở dữ liệu, cache và hệ thống lưu trữ
5. Lớp quan sát và vận hành: Monitoring, logging, tracing, alerting và công cụ quản trị
Giá trị của cách phân lớp nằm ở khả năng xác định miền mở rộng. Chẳng hạn, nếu lượng request tăng nhưng phần lớn tác vụ nặng có thể đưa vào queue, lớp API có thể tiếp tục phản hồi nhanh trong khi worker được mở rộng riêng để xử lý backlog.
Tính không trạng thái của tầng ứng dụng cũng có ý nghĩa quan trọng. Khi session hoặc trạng thái xử lý không bị khóa vào một instance cụ thể, request có thể được phân phối linh hoạt hơn giữa nhiều instance. Ngược lại, stateful component thường đòi hỏi cơ chế đồng bộ, replication hoặc phân vùng phù hợp trước khi có thể scale ngang.
Tách thành phần không có nghĩa là chia hệ thống thành càng nhiều service càng tốt. Mỗi ranh giới mới tạo thêm yêu cầu về mạng, quan sát, triển khai, quản lý lỗi và dữ liệu. Vì vậy, mức độ phân tách phải tương xứng với nhu cầu mở rộng độc lập của từng thành phần.
Dữ liệu phải được thiết kế ra sao để không trở thành điểm nghẽn?
Trong nhiều hệ thống, tầng ứng dụng có thể thêm instance khá dễ dàng nhưng cơ sở dữ liệu trung tâm lại trở thành giới hạn mở rộng. Vì vậy, thiết kế hạ tầng số chỉ thực sự có khả năng mở rộng khi kiến trúc dữ liệu được xem xét cùng với compute.
Một số cơ chế thường được cân nhắc gồm:
· Caching: Giảm số lần truy cập dữ liệu có tính lặp lại
· Read replica: Phân tách một phần tải đọc khỏi hệ thống ghi chính
· Partitioning hoặc sharding: Phân chia dữ liệu để giảm tải tập trung vào một nút
· Queue: Tách các tác vụ ghi hoặc xử lý nặng khỏi luồng request đồng bộ khi phù hợp
· Connection pooling: Kiểm soát số lượng kết nối tới cơ sở dữ liệu
· Data lifecycle: Xác định dữ liệu nào cần truy cập thường xuyên, dữ liệu nào có thể lưu trữ theo tầng
Điều quan trọng là mỗi cơ chế giải quyết một loại nút thắt khác nhau. Cache có thể giảm read load nhưng không tự giải quyết write contention. Read replica tăng năng lực đọc nhưng không đồng nghĩa với việc năng lực ghi tăng tương ứng. Sharding có thể mở rộng dữ liệu theo phân vùng nhưng làm tăng độ phức tạp của truy vấn và vận hành.
Do đó, trước khi lựa chọn giải pháp, cần đo các chỉ số như read/write throughput, query latency, connection utilization, storage growth và replication lag. Những dữ liệu này cho biết giới hạn thực tế nằm ở CPU, I/O, kết nối, truy vấn hay cấu trúc dữ liệu.
Autoscaling và tự động hóa nên được thiết kế theo nguyên tắc nào?
Autoscaling chỉ hiệu quả khi hệ thống có thể thay đổi quy mô một cách an toàn. Việc tự động thêm instance nhưng không giải quyết được bottleneck ở database, queue hoặc network sẽ chỉ chuyển điểm nghẽn sang vị trí khác.
Một thiết kế autoscaling cần xác định rõ:
· Tín hiệu mở rộng: CPU, memory, request rate, latency, queue depth hoặc metric phù hợp với workload
· Ngưỡng kích hoạt: Mức tải mà tại đó năng lực hiện tại bắt đầu không đáp ứng SLO
· Tốc độ mở rộng: Số lượng tài nguyên được bổ sung trong mỗi chu kỳ
· Thời gian khởi tạo: Khoảng thời gian từ lúc phát hiện tải đến khi tài nguyên mới sẵn sàng
· Ngưỡng thu hẹp: Điều kiện để giảm tài nguyên mà không gây dao động liên tục
· Giới hạn tối thiểu và tối đa: Bảo vệ cả khả năng đáp ứng lẫn chi phí
Một hệ thống có workload tăng đột biến cần phản ứng nhanh hơn hệ thống có tải tăng đều. Vì vậy, không nên dùng một metric duy nhất cho mọi loại dịch vụ. Với API, latency và request rate có thể phản ánh tải tốt hơn CPU trong một số trường hợp; với worker xử lý bất đồng bộ, queue depth có thể có giá trị hơn.
Hạ tầng cũng nên được quản lý bằng Infrastructure as Code và pipeline tự động để cấu hình, triển khai và thay đổi tài nguyên có tính lặp lại. Khi quy mô tăng, tự động hóa giúp giảm phụ thuộc vào thao tác thủ công và làm cho việc tái tạo môi trường nhất quán hơn.
Khả năng mở rộng phải đi cùng độ tin cậy và quan sát như thế nào?
Scale mà không kiểm soát failure mode có thể khiến hệ thống lớn hơn nhưng không ổn định hơn. Khi số lượng thành phần tăng, cần xác định rõ cách hệ thống phản ứng khi một instance, zone, service hoặc dependency gặp sự cố.
Các cơ chế quan trọng gồm:
· Health check: Loại instance không lành mạnh khỏi luồng phục vụ
· Timeout: Ngăn request chờ vô hạn khi dependency gặp vấn đề
· Retry có kiểm soát: Tránh tạo thêm tải khi hệ thống đang quá tải
· Circuit breaker: Hạn chế lan truyền lỗi giữa các service
· Rate limiting: Bảo vệ hệ thống trước lưu lượng vượt khả năng xử lý
· Redundancy: Tránh phụ thuộc vào một điểm lỗi duy nhất
· Backup và recovery: Đảm bảo dữ liệu có thể được khôi phục theo mục tiêu đã xác định
Observability cũng phải mở rộng cùng hệ thống. Monitoring nên liên kết các chỉ số về latency, traffic, errors và saturation để phân biệt giữa tăng tải bình thường và suy giảm năng lực.
SLO và các metric vận hành nên được dùng làm cơ sở quyết định thay vì chỉ dựa vào cảm nhận. Ví dụ, nếu request rate tăng nhưng p95 latency và error rate vẫn nằm trong SLO, hệ thống chưa nhất thiết cần mở rộng ngay. Ngược lại, CPU chưa đạt mức cao nhưng latency hoặc queue depth đã vượt ngưỡng vận hành thì việc chỉ nhìn CPU có thể dẫn tới quyết định sai.
Làm thế nào để thiết kế hạ tầng có thể thay đổi mà không phải tái xây dựng?
Khả năng mở rộng dài hạn không chỉ là đáp ứng thêm tải hiện tại mà còn phải giảm chi phí của những thay đổi trong tương lai. Vì vậy, kiến trúc nên tách các quyết định có thể thay đổi khỏi những thành phần khó thay đổi.
Một số nguyên tắc thực tế gồm:
· Thiết kế module: Các thành phần có ranh giới và trách nhiệm rõ ràng
· API contract ổn định: Cho phép một thành phần thay đổi mà không buộc toàn bộ hệ thống thay đổi
· Stateless application khi phù hợp: Giúp scale và thay thế instance dễ hơn
· Infrastructure as Code: Biến hạ tầng thành cấu hình có thể kiểm soát phiên bản
· Tự động hóa triển khai: Giảm rủi ro khi số lượng môi trường và instance tăng
· Capacity planning: Dự báo nhu cầu dựa trên xu hướng traffic, workload và tài nguyên
· Kiểm thử tải: Xác định bottleneck trước khi hệ thống bước vào trạng thái quá tải
Điểm quan trọng là không nên tối ưu hạ tầng theo một kịch bản tăng trưởng duy nhất. Thiết kế cần chỉ ra điều gì xảy ra khi tải tăng gấp nhiều lần, khi một dependency chậm đi, khi database đạt giới hạn hoặc khi một vùng hạ tầng mất khả năng phục vụ.
Một kiến trúc được xem là có khả năng mở rộng tốt khi việc tăng quy mô không tạo ra một bottleneck mới nhanh hơn tốc độ tăng trưởng của nhu cầu. Do đó, capacity planning phải được thực hiện theo toàn bộ chuỗi phụ thuộc thay vì chỉ tính số máy chủ ứng dụng.
Thiết kế hạ tầng số để đáp ứng tăng trưởng nên bắt đầu từ mô hình tải và các giới hạn vận hành, sau đó mới chọn công nghệ. Kiến trúc cần ưu tiên khả năng mở rộng độc lập, mở rộng ngang ở nơi phù hợp, thiết kế dữ liệu tránh điểm nghẽn, autoscaling dựa trên metric thực tế và tự động hóa toàn bộ vòng đời hạ tầng
Quan trọng hơn, khả năng mở rộng phải được thiết kế cùng độ tin cậy, quan sát, bảo mật và phục hồi. Khi mỗi thành phần đều có giới hạn, chỉ số đo và cơ chế mở rộng rõ ràng, hạ tầng có thể thích ứng với tăng trưởng mà không phải tái xây dựng toàn bộ hệ thống mỗi khi nhu cầu thay đổi

GỬI Ý KIẾN BÌNH LUẬN
Bài xem nhiều